Как собрать семантическое ядро для продвижения сайта


Один из важных этапов поисковой оптимизации — сбор семантического ядра. Правильно подобранная семантика помогает привлекать целевой трафик из поиска и усиливает SEO-продвижение. Разберемся, как собрать СЯ самостоятельно с помощью инструментов click.ru, чем различается семантика для контекстной рекламы и SEO и каких ошибок стоит избегать.
Оглавление
- Этапы подбора семантического ядра
- Этап 1. Сбор базовых ключевых слов (базисов) и съем частотностей
- Этап 2. Расширение семантики
- Похожие запросы в Вордстате
- Парсинг (автоматический сбор) поисковых подсказок
- Парсинг (автоматический сбор) фраз-ассоциаций
- Фразы из аналитических сервисов поисковых систем
- Анализ конкурентов
- Этап 3. Очистка семантического ядра
- Этап 4. Кластеризация семантического ядра
- Как автоматизировать создание семантического ядра с помощью click.ru
- В чем различается семантика для контекстной рекламы и SEO
- Частые ошибки при сборе семантического ядра
Этапы подбора семантического ядра
Работу над семантическим ядром удобнее разделить на несколько этапов. Сначала определяют базовые запросы и расширяют их с помощью поисковых систем, конкурентов и SEO-сервисов. Затем полученный список очищают, проверяют частотность и релевантность, после чего запросы кластеризуют и распределяют по страницам сайта. Рассмотрим каждый этап подробнее.
Этап 1. Сбор базовых ключевых слов (базисов) и съем частотностей
Базисы — высокочастотные запросы, которые пользователи часто вводят в поиске. На их основе подбирают более точные средне- и низкочастотные ключи. Чем конкретнее запрос, тем точнее он отражает потребность пользователя и тем более целевой трафик может привести. Базисы описывают именно основные направления.
Например, интернет-магазин продает холодильники. Базисы могут выглядеть так:
- «купить холодильник»;
- «холодильники цена»;
- «двухкамерный холодильник»;
- «встраиваемый холодильник»;
- «холодильник No Frost»;
- «холодильник для дачи».
Посмотрим, как на практике выглядит сбор базисов, на примере Яндекс Вордстата — классического инструмента от Яндекса.
Вводим базовый запрос, и сервис показывает популярные фразы, в которых он встречается, а также похожие формулировки.
Если компания работает только в определенном регионе, обязательно учитываем географию. Для магазина в Москве, который не доставляет технику по России, статистика по всей стране мало что скажет о реальном локальном спросе. В Wordstat можно посмотреть распределение запросов по регионам и городам. Для региональной статистики сервис использует данные за последние 30 дней.

Например, вводим «купить холодильник» и смотрим на раздел «Популярные». Это все ключевые фразы, которые содержат указанный в строке сервиса базис. Из результатов выбираем запросы, которые соответствуют ассортименту и тематике сайта. В колонке «Число запросов» показана частотность. Это сумма показов всех запросов, которые содержат конкретную фразу.

Частотность помогает примерно оценить потенциальный спрос по запросу — сколько раз пользователи ищут его в течение месяца. Однако это не значит, что столько же человек перейдут на сайт. Количество переходов зависит в том числе от позиции страницы в выдаче и ее CTR: обычно, чем выше сайт находится в результатах поиска, тем больше кликов.
Чтобы получить более точные данные и убрать запросы с нулевой или слишком низкой частотностью, используем операторы.
Например:
- «купить холодильник» — фиксирует количество слов во фразе, поэтому дополнительные слова вроде «недорого» уже не учитываются;
- [купить холодильник] — дополнительно фиксирует порядок слов;
- !холодильник — фиксирует форму слова;
- купить холодильник -бу — исключает запросы со словом «бу».
Операторы можно комбинировать. Wordstat поддерживает -, !, +, кавычки, квадратные скобки, круглые скобки и |.
Необязательно проверять операторами каждую фразу. Они особенно полезны, когда нужно точнее оценить спрос на важный запрос или разобраться с неоднозначной семантикой.
Помните, что частотность одного месяца может вводить в заблуждение. Во вкладке «Динамика» Wordstat показывает историю спроса. По умолчанию доступна помесячная статистика за последние два года, а при выборе периода можно смотреть данные начиная с 2018 года. Есть также недельная и дневная детализация.
Поэтому для сезонных тематик проверяйте:
- текущую частотность;
- показатели за аналогичный период прошлого года;
- средний уровень спроса вне сезона;
- месяцы роста и падения.
Это позволит отличить устойчивый спрос от временного всплеска.

Этап 2. Расширение семантики
При сборе семантического ядра не стоит ограничиваться запросами, которые вы нашли по базовым ключам в Вордстате. Чтобы охватить больше вариантов поискового спроса и не пропустить потенциально ценные фразы, нужно расширить первоначальный список.
Похожие запросы в Вордстате
Самый простой путь. Сервис показывает похожие запросы, которые могут быть связаны с исходной темой. Смотрим список, отбираем релевантные сайту фразы и добавляем их в семантическое ядро.
Можно открыть каждый запрос и посмотреть связанные с ним формулировки. Если данных много, результаты удобнее выгрузить в CSV или XLSX и продолжить работу уже в таблице.

Парсинг (автоматический сбор) поисковых подсказок
Еще один источник семантики — поисковые подсказки Яндекса и Google. С их помощью можно найти дополнительные низкочастотные запросы, точнее понять потребности аудитории и подобрать темы для статей, инструкций и других информационных материалов.
Подсказки появляются, когда пользователь начинает вводить запрос в поисковую строку. Поисковые системы формируют их автоматически на основе собственных алгоритмов и актуального спроса. На выдачу также могут влиять регион и история поиска конкретного пользователя.
Если базовых запросов много, собирать подсказки вручную неудобно. В таком случае процесс можно автоматизировать с помощью парсеров, которые выгружают варианты сразу для большого списка ключевых фраз.
Парсинг (автоматический сбор) фраз-ассоциаций
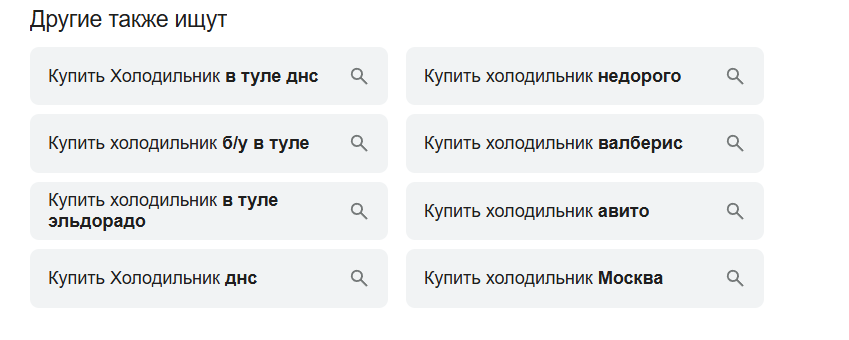
Фразы-ассоциации указаны внизу выдачи в виде списков под названиями «Люди ищут» в Яндексе и «Другие также ищут» в Google. С их помощью можно узнать больше об интересах аудитории и точнее подобрать семантику.

Фразы из аналитических сервисов поисковых систем
В Яндекс Метрике можно увидеть статистику по запросам, которые привели пользователей на сайт из Яндекса и Яндекс Карт, Rambler, Bing. Отчет представлен в группе «Источники»:

Найденные таким образом запросы можно включить в СЯ и начать прорабатывать.
Еще один инструмент — Яндекс Вебмастер. Статистика находится в разделе «Эффективность».

Для дополнения семантики будут полезны «Статистика запросов» и «Подбор запросов и анализ рынка». Во вкладке «Популярные запросы» в первом разделе можно найти целевые ключи, по которым были показы и клики.
«Подбор запросов и анализ рынка» помогает собрать по базовому ключу все возможные варианты с учетом региона, конкурентности, спроса, минус-слов и других показателей. Данные можно выгрузить в XLS.

Информацию о запросах, по которым сайт показывался в Google, можно найти в Google Search Console в отчете «Эффективность» → «Результаты поиска» в Google Search Console. Для каждого запроса есть количество кликов и показов. Также можно узнать средний CTR и позицию в поиске. Сервис показывает страницы с большим потенциальным трафиком, но низкой кликабельностью. Их оптимизировать прежде всего.
Анализ конкурентов
Идеи для дополнения семантики можно почерпнуть у конкурентов из топа поисковой выдачи с помощью специальных инструментов. Например, Keys.so, SpyWords, Топвизор, Букварикс и других. Многие из них доступны на маркетплейсе click.ru за бонусы партнерской программы.
При этом чужую семантику нельзя просто выгрузить и целиком добавить в свое ядро. У конкурента могут быть другие товары, география, услуги или аудитория. Каждый новый кластер нужно проверять на соответствие вашему бизнесу.
Этап 3. Очистка семантического ядра
После сбора семантики в таблице останутся дубли, служебные символы и нерелевантные запросы. Перед кластеризацией список нужно привести в порядок.
Удалите дубликаты. Одни и те же запросы могут попасть в ядро из разных источников. В Google Таблицах выделите столбец с ключевыми фразами, откройте «Данные» → «Очистка данных» → «Удалить повторы». Если рядом с запросами хранятся частотность и другие показатели, следите, чтобы при очистке данные в строках не сместились.

Уберите служебные символы. Например, после работы с Вордстатом в запросах могут остаться операторы. Быстрее всего удалить их через функцию в разделе «Правка» → «Найти и заменить».

Укажите символ, который хотите убрать, оставьте поле замены пустым и примените действие ко всему диапазону.
Отсортируйте запросы. Удобнее всего расположить фразы по убыванию частотности. Так сначала будут видны наиболее популярные запросы, а ниже — более узкие. В Google Таблицах для этого выделите диапазон и выберите «Данные» → «Сортировать диапазон». После удаления нерелевантных фраз сортировку можно повторить.

Удалите нерелевантные запросы. Даже после автоматической обработки в ядре могут остаться фразы, которые не соответствуют сайту или задачам бизнеса. Их лучше проверить вручную: сервисы помогают ускорить чистку, но не всегда правильно определяют пользовательский интент.
В первую очередь уберите запросы:
- с товарами и услугами, которых нет в ассортименте;
- с городами, районами и другими локациями, где компания не работает;
- с названиями конкурентов, если такая семантика не нужна для отдельных задач;
- с явно другим интентом — когда пользователь ищет не то, что предлагает сайт;
- с непонятными словами и формулировками;
- с ошибками и опечатками, если поисковая система корректно распознает исходный запрос;
- с полными и неявными дублями, которые выражают одну и ту же потребность.
С низкочастотными запросами важно быть осторожным. Универсального порога, ниже которого фразу нужно удалить, нет. Если запрос встречается редко, но точно описывает товар или потребность пользователя, он может приводить ценный целевой трафик. А вот низкочастотные фразы, которые лишь повторяют более популярный запрос с незначительным или бессмысленным уточнением, можно убрать.
Этап 4. Кластеризация семантического ядра
После очистки запросы нужно объединить в смысловые группы — кластеры. Кластеризовать запросы можно вручную или с помощью специальных сервисов.
Ручная кластеризация. Подходит для небольшого семантического ядра. Запросы распределяют по группам в Excel или Google Таблицах с учетом смысла и поисковой выдачи. Если по нескольким фразам в топе появляются одни и те же страницы, скорее всего, запросы можно объединить в один кластер.
Автоматическая кластеризация. Для большого ядра удобнее использовать специальные сервисы. Они анализируют поисковую выдачу по каждому запросу, сравнивают URL в топе и объединяют фразы с похожими результатами. Готовую группировку остается проверить и при необходимости скорректировать вручную. Для автоматической кластеризации можно использовать Key Collector, Serpstat, Rush Analytics, Keys.so, Топвизор и другие SEO-инструменты. Многие из них также доступны за бонусы на маркетплейсе click.ru.
Как автоматизировать создание семантического ядра с помощью click.ru
В рекламной экосистеме click.ru есть собственные профессиональные инструменты, которые позволяют облегчить и ускорить работу по сбору семантического ядра.
Сбор частотности. С помощью инструмент «Парсер Wordstat» можно за несколько минут собрать частотность любого количества ключей в указанных регионах. Это намного удобнее, чем вводить вручную в Вордстате каждый запрос, а потом объединять списки в общее ядро.
Можно добавить список фраз вручную или загрузить файл XLSX, указать регион, добавить операторы.


Расширение семантического ядра. Для пользователей click.ru доступно сразу несколько инструментов, которые помогут найти множество запросов.
Инструмент «Сбор поисковых подсказок» собирает подсказки из Яндекса, Google и YouTube с учетом регионов. Загрузить ключи можно XLSX-файлом или списком. Доступны все регионы поисковых систем. Среди способов сбора — по заданным фразам, по исходным фразам с добавлением через пробел букв латинского алфавита [A-Z], кириллического алфавита [А-Я], цифр [0-9]. Глубина парсинга: 1-3.

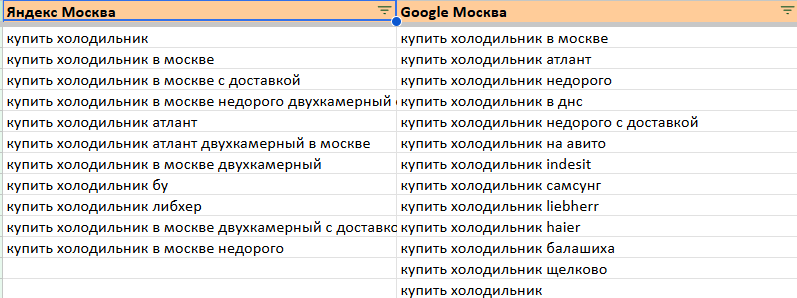
Инструмент для сбора фраз-ассоциаций от click.ru собирает похожие запросы из Яндекса и Google из списка или XLSX-файла по нужным регионам. Можно указать минус слова.
Еще один способ найти дополнительные запросы — изучить title и заголовки h1 конкурентов. В этих метатегах встречаются наиболее важные фразы. Некоторые специалисты до сих пор заполняют метатег keywords. Его содержимое тоже может подсказать идеи для расширения семантики. Парсер метатегов и заголовков click.ru выгружает title, description, keywords, а также заголовки h1–h6. Для анализа можно загрузить XML-карту сайта, XLSX-файл или обычный список URL конкурента.


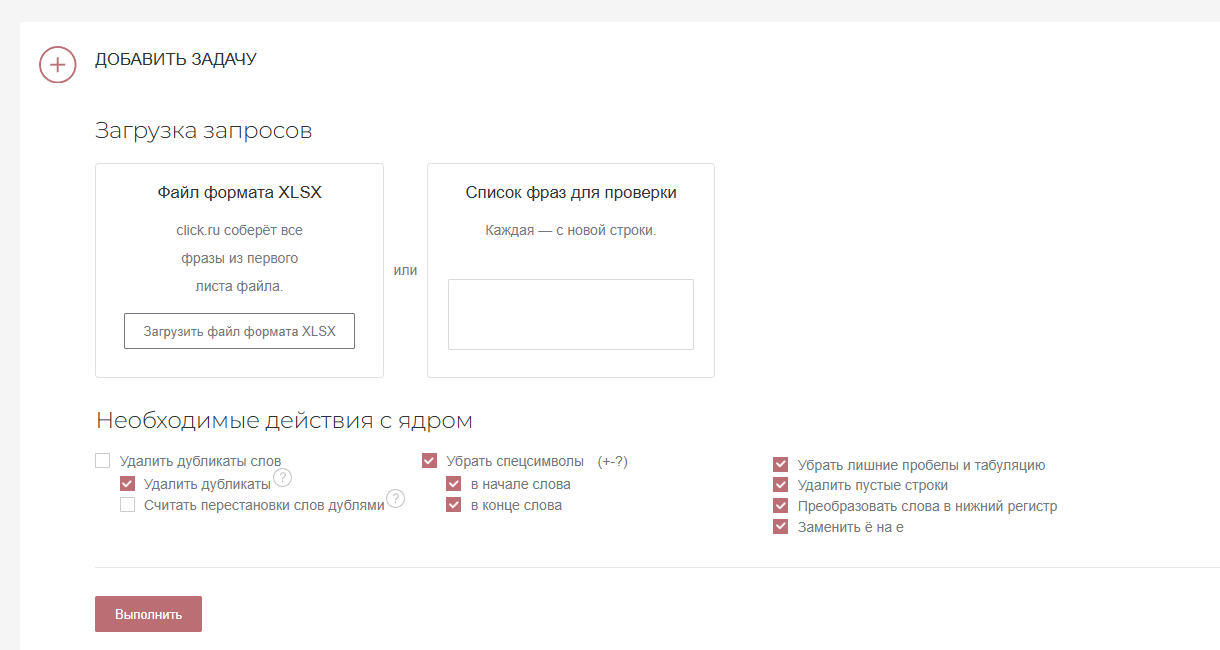
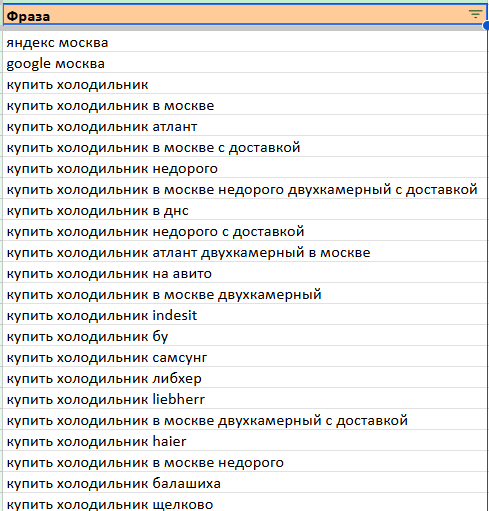
Очистка семантики и кластеризация запросов. «Нормализатор слов» помогает удалить дубликаты, лишние символы, пустые строки, табуляцию, букву ё и многое другое.
А инструмент «Кластеризация запросов» быстро группирует запросы в кластеры. Доступно 2 режима: профессиональная настройка с указанием точности, регионов и поисковых систем, и сравнение топов. Можно загрузить от 20 до 10 000 ключей.
В чем различается семантика для контекстной рекламы и SEO
В SEO семантика помогает выстроить структуру сайта и охватить органический спрос, а в контекстной рекламе — показать объявления по запросам, которые с большей вероятностью приведут к целевому действию.
Охват. Для SEO обычно собирают широкое ядро. В него входят коммерческие, информационные высоко- и низкочастотные запросы. Так проще привлекать аудиторию на разных этапах выбора. В контекстной рекламе чаще делают акцент на коммерческих запросах, например «купить», «заказать», «цена». Даже низкочастотная фраза может быть полезна, если она отражает конкретную потребность аудитории.
Работа с нерелевантной семантикой. В SEO неподходящие запросы просто исключают, чтобы страницы соответствовали поисковому интенту. В контекстной рекламе фильтрация особенно важна из-за прямых расходов на продвижение. Для этого используют минус-слова и другие настройки, которые помогают отсечь нецелевые показы и не расходовать на них бюджет.
Частотность и сезонность. В SEO продвижение по запросам дает стабильный накопительный эффект, но под краткосрочные сезонные акции оптимизировать сайт нецелесообразно. Контекстная реклама позволяет быстрее реагировать на изменения спроса, например запускать отдельные кампании под сезонные товары, акции или краткосрочные предложения.
Частые ошибки при сборе семантического ядра
Собирать только высокочастотные запросы. Кажется логичным выбирать фразы, которые ищут чаще всего, но по ним обычно выше конкуренция, а намерение пользователя может быть слишком размытым. Средне- и низкочастотные запросы точнее описывают потребность и способны приводить более целевой трафик.
Копировать все запросы конкурентов. У компаний различаются ассортимент, регионы работы, аудитория и бизнес-модель.
Удалять всю информационную семантику. Если оставить только фразы со словами «купить», «цена» и «заказать», можно потерять аудиторию, которая пока выбирает и сравнивает варианты. Информационные запросы пригодятся для статей, инструкций, обзоров и других материалов.
Не чистить собранную семантику. В ядро из разных источников попадают дубли, нерелевантные фразы, неподходящие регионы, товары и услуги, которых нет на сайте. Если оставить их, они усложнят кластеризацию и дальнейшую работу.
Считать семантическое ядро готовым раз и навсегда. Спрос меняется, появляются новые товары, услуги, тренды. Поэтому ядро нужно периодически дополнять актуальными запросами из поисковой аналитики.